LLM : c’est quoi un grand modèle de langage ?
Les LLM sont derrière les assistants d’IA, les outils de code et les agents qui se sont installés dans le quotidien des développeurs. Savoir comment ils fonctionnent aide à comprendre ce qu’ils font bien, ce qu’ils font mal, et ce qu’ils coûtent. La formation IA pour développeurs de Dyma commence par là : ses deux premiers chapitres portent sur les LLM, les modèles de raisonnement et la mécanique du contexte, avant les API et les agents. Ce guide en donne l’essentiel. Les faits ont été vérifiés le 11 novembre 2026 sur les articles de recherche cités et sur les documentations d’Anthropic, d’OpenAI, de Google, de Mistral AI et de DeepSeek.
Un LLM, c’est quoi ?
Un LLM est un modèle de langage, c’est-à-dire un programme qui calcule la suite la plus probable d’un texte. Il est « grand » par le nombre de ses paramètres, les valeurs numériques ajustées pendant l’entraînement : GPT-3, présenté par OpenAI en 2020, en comptait déjà 175 milliards. La documentation d’Anthropic les définit comme des modèles de langage dotés de très nombreux paramètres, entraînés sur de vastes quantités de textes, capables de répondre, de résumer ou de rédiger.
GPT-3 repose sur une architecture présentée en juin 2017 dans l’article « Attention Is All You Need » d’Ashish Vaswani et ses coauteurs : le Transformer. Son mécanisme d’attention permet au modèle de pondérer, pour chaque mot, l’importance des autres mots du texte. Sans les boucles des réseaux récurrents qui l’ont précédé, il se parallélise mieux et s’entraîne plus vite.
Comment il est entraîné
Un assistant comme Claude ne sort pas tel quel de la lecture d’un immense corpus. Il passe par plusieurs phases, que la documentation d’Anthropic décrit ainsi :
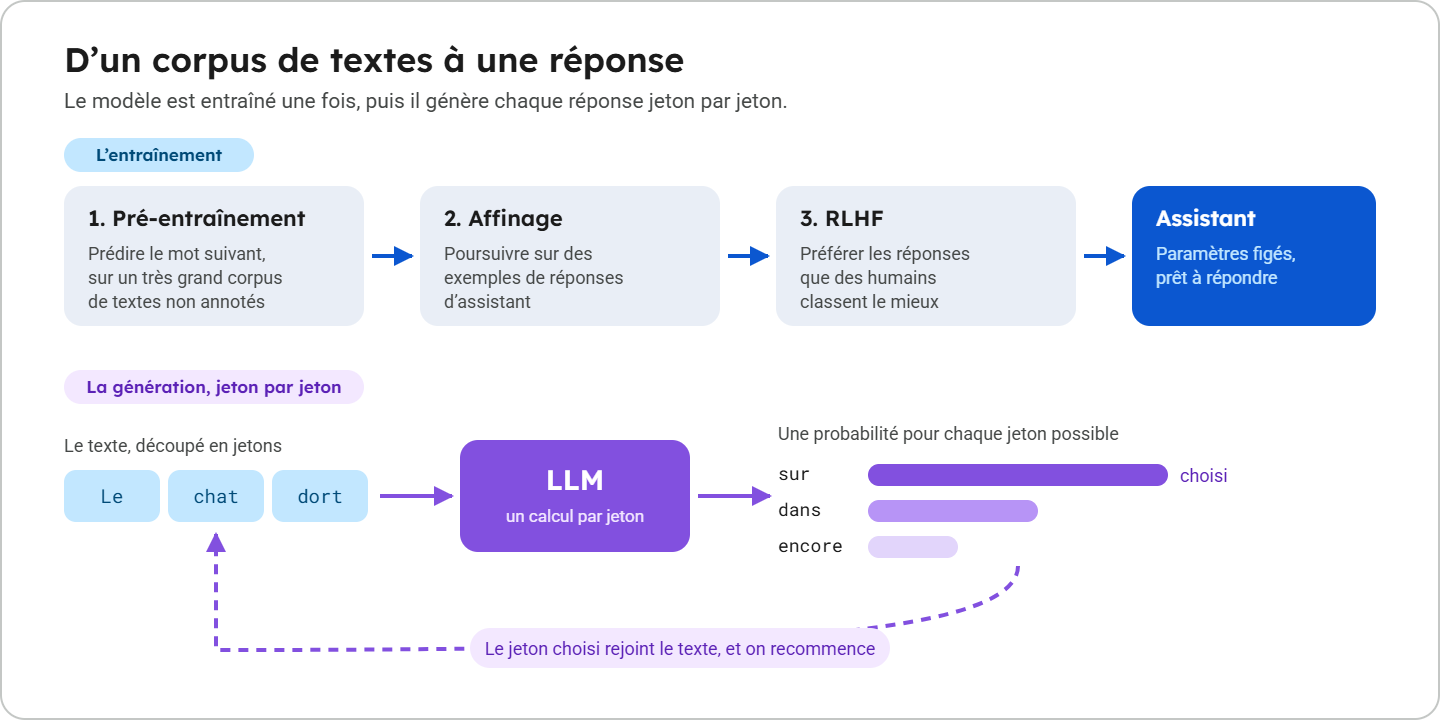
- Pré-entraîner : le modèle lit un très grand corpus de textes, sans annotation, et apprend à prédire le mot suivant. Il en sort un modèle qui complète bien les textes, mais suit mal les consignes.
- Affiner (fine-tuning) : on poursuit l’entraînement sur des exemples choisis, par exemple des réponses rédigées par des humains, pour lui apprendre à se comporter en assistant.
- Aligner par RLHF, l’apprentissage par renforcement à partir de retours humains : des personnes classent plusieurs réponses, et le modèle apprend à préférer celles qu’elles ont mieux notées.
Ces dernières étapes pèsent lourd. En 2022, OpenAI a montré qu’un modèle de 1,3 milliard de paramètres, affiné de cette façon (InstructGPT), était préféré par des évaluateurs humains au GPT-3 de 175 milliards de paramètres, cent fois plus gros.
Jetons et fenêtre de contexte
Un LLM ne lit pas des lettres ni des mots, mais des jetons (tokens) : des morceaux de texte qui peuvent être un mot, une partie de mot, un caractère ou même un octet. Un mot courant tient souvent en un jeton, un mot rare en plusieurs. Pour générer une réponse, le modèle calcule une probabilité pour chaque jeton possible, en choisit un, l’ajoute au texte et recommence.
La fenêtre de contexte est la quantité de texte que le modèle peut prendre en compte d’un coup : sa mémoire de travail, distincte de ce qu’il a appris pendant l’entraînement. Chez Anthropic, tout y compte : les instructions, l’historique de la conversation, les documents joints et la réponse elle-même.
| Notion | Ce qu’il faut retenir |
|---|---|
| Jeton | Environ 3,5 caractères en anglais sur les anciens modèles Claude ; les modèles depuis Claude Opus 4.7 produisent environ 30 % de jetons de plus pour le même texte |
| Fenêtre de contexte | 1 million de jetons sur les modèles Claude actuels, soit environ 555 000 mots |
| Sortie maximale | 128 000 jetons par réponse sur ces mêmes modèles |
| Température | Basse, des réponses plus prévisibles ; haute, plus variées. Même à zéro, deux appels identiques peuvent différer |
| Prix | Les API facturent au jeton, en distinguant les jetons d’entrée et ceux de sortie |
Une grande fenêtre ne garantit pas une bonne lecture : la documentation d’Anthropic note que la précision et le rappel se dégradent à mesure que le contexte s’allonge, ce qu’elle appelle le « context rot ». Choisir ce qu’on met dans le contexte compte autant que la place disponible.
LLM et modèles de raisonnement
Un LLM classique répond d’une traite : il n’a ni brouillon, ni retour en arrière. Les modèles de raisonnement, parfois appelés LRM (Large Reasoning Models), réfléchissent avant de répondre. Chez Anthropic, cette fonction s’appelle le thinking : le modèle reformule la question, essaie des approches, vérifie des résultats intermédiaires et abandonne les pistes qui ne tiennent pas, puis rédige sa réponse.
La réflexion améliore les résultats sur les mathématiques, le code, l’analyse et les longues tâches d’agent. Elle a un coût : les jetons de réflexion se facturent comme des jetons de sortie, même quand leur texte ne vous est pas renvoyé. Sur les modèles Claude actuels, la réflexion est adaptative : le modèle décide lui-même combien réfléchir, selon un niveau d’effort que vous pouvez régler. Google présente lui aussi ses Gemini 4 comme des modèles de raisonnement, et OpenAI renvoie, pour chacun de ses modèles phares, à son guide du raisonnement.
Les limites
Un LLM est un outil puissant, pas une source de vérité. Ses défauts sont connus, et chacun a sa parade.
| Limite | Parade |
|---|---|
| Hallucinations : un texte faux mais plausible | L’autoriser, dans le prompt, à dire« je ne sais pas », lui faire citer ses sources, vérifier |
| Connaissances arrêtées à une date (juin 2026 pour les modèles Claude actuels) | Lui fournir les documents à jour, par exemple avec un RAG ou la recherche web |
| Ignore vos données privées | Les lui donner dans le contexte, ou par des connecteurs et des outils |
| Précision qui baisse sur les contextes très longs | Ne donner que le nécessaire, résumer les longues conversations |
| Réponses non déterministes | Tester sur plusieurs essais, comparer les réponses |
Pour un développeur, la règle est simple : relire ce que produit le modèle comme on relit le code d’un collègue, et automatiser la vérification quand on le peut, avec des tests.
Les principaux LLM
Les gammes changent vite : le tableau ci-dessous donne les modèles mis en avant par chaque éditeur dans sa documentation, au 11 novembre 2026. Certains ne sont accessibles que par API ou dans les applications de leur éditeur ; d’autres publient leurs poids, que l’on peut télécharger et faire tourner sur ses propres machines.
| Éditeur | Modèles | Accès |
|---|---|---|
| Anthropic | Claude Fable 5.2, Opus 5.5, Sonnet 5.5, Haiku 5.5 | API, applications Claude, Claude Code |
| OpenAI | GPT-6 Astra, GPT-6.1 Sol, GPT-6.1 Terra, GPT-6 Luna | API |
| Gemini 4 Carbon, Gemini 4 Argon, Gemini 3.8 Flash | API (Google AI Studio) | |
| Mistral AI | Mistral Large 4, Mistral Small 4 | API, poids ouverts (Apache 2.0 pour Small 4) |
| DeepSeek | DeepSeek V4 Pro, DeepSeek V4.1 Flash | API, poids ouverts (licence MIT) |
| Les utiliser dans vos applications | La formation IA pour développeurs : API d’OpenAI et d’Anthropic, SDK, agents, MCP | |
Pour comparer les modèles de Claude entre eux et savoir lequel choisir dans l’application, la formation Claude leur consacre une partie de son programme. Pour coder avec un LLM directement dans votre terminal, voyez la formation Claude Code.
Questions fréquentes
Que veut dire LLM ?
LLM, IA générative, chatbot : quelle différence ?
Un LLM apprend-il de mes conversations ?
Peut-on faire tourner un LLM sur son ordinateur ?
Qu’est-ce que le fine-tuning ?