RAG (Retrieval-Augmented Generation) : définition et exemple
Un LLM ne connaît que ce qu’il a vu pendant son entraînement : ni vos procédures internes, ni votre catalogue, ni l’actualité de la semaine. Le RAG comble ce manque sans réentraîner le modèle. La formation IA pour développeurs de Dyma y consacre une leçon d’introduction, dans le chapitre sur l’écosystème des LLM, à côté des API, des outils et des agents. Ce guide explique le principe, les étapes d’un pipeline, le rôle des embeddings et de la base vectorielle, avec un exemple de code qui tourne tel quel. Les faits ont été vérifiés le 11 novembre 2026 sur l’article fondateur du RAG et sur les documentations d’Anthropic et de MongoDB.
Le RAG, c’est quoi ?
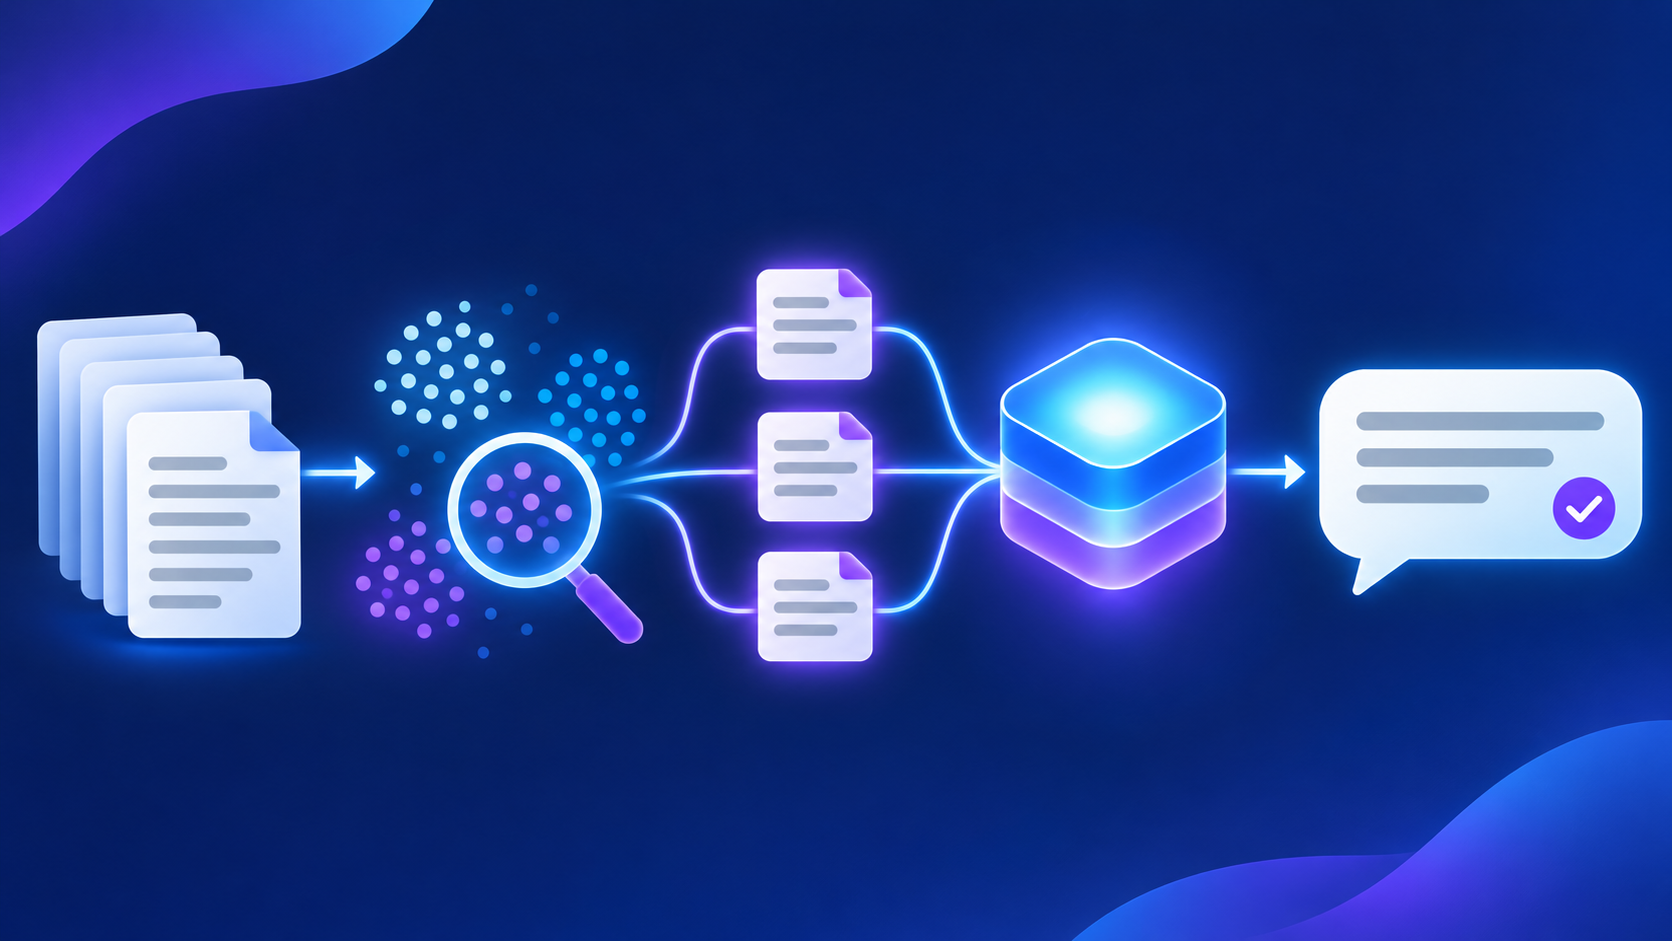
Le RAG est une méthode en deux temps. D’abord la récupération (retrieval) : le système cherche, dans une base de connaissances, les passages les plus proches de la question posée. Ensuite la génération : il colle ces passages dans le prompt, et le modèle rédige sa réponse en s’y appuyant. Anthropic le résume ainsi : on récupère l’information pertinente et on l’ajoute au prompt de l’utilisateur.
Le terme vient d’un article de recherche publié en mai 2020 par Patrick Lewis et ses coauteurs, « Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks », accepté à la conférence NeurIPS 2020. Leur modèle combinait deux mémoires : celle du modèle lui-même, stockée dans ses paramètres, et une mémoire externe, un index vectoriel de Wikipédia interrogé par un moteur de recherche neuronal. Sur trois jeux de questions-réponses en domaine ouvert, il obtenait les meilleurs résultats de l’époque ; et quand il rédigeait, ses textes étaient plus précis et plus factuels que ceux d’un modèle sans recherche.
Pourquoi un LLM en a besoin
Un grand modèle de langage apprend en lisant un très grand volume de textes, jusqu’à une date de coupure. Les modèles Claude actuels, par exemple, ont des connaissances fiables jusqu’en juin 2026. Tout ce qui est plus récent, ou qui n’a jamais été public, lui est inconnu. Et quand il ne sait pas, un modèle peut produire un texte faux mais plausible : c’est ce qu’on appelle une hallucination.
| Problème du LLM seul | Ce qu’apporte le RAG |
|---|---|
| Il ignore vos documents internes | Il lit les extraits pertinents de votre base, à chaque question |
| Ses connaissances s’arrêtent à une date | Une base mise à jour suffit, sans réentraîner le modèle |
| Il peut inventer une réponse | Il répond à partir d’extraits qu’il peut citer, et que vous pouvez vérifier |
La documentation d’Anthropic rappelle la limite : un RAG ne vaut que ce que valent la base de connaissances et les passages retrouvés. Si la recherche ramène le mauvais document, le modèle répondra, avec assurance, à côté.
Les étapes d’un pipeline RAG
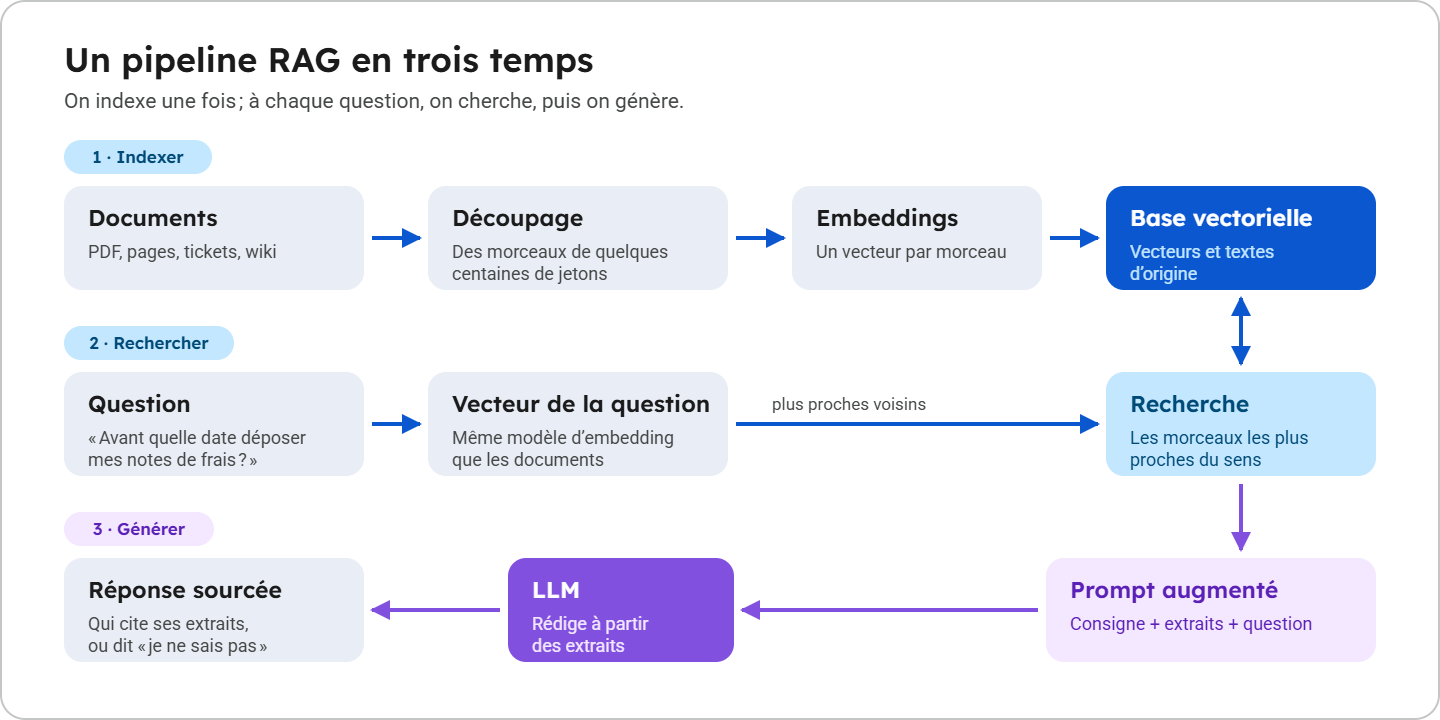
Un pipeline RAG a trois temps. L’indexation se fait une fois, puis à chaque mise à jour des documents ; la recherche et la génération ont lieu à chaque question.
- Découper les documents en morceaux (chunks), en général de quelques centaines de jetons au plus.
- Vectoriser chaque morceau avec un modèle d’embedding, qui le transforme en une liste de nombres.
- Stocker ces vecteurs, avec le texte d’origine, dans une base vectorielle, par exemple MongoDB Atlas et sa recherche vectorielle.
- Rechercher : vectoriser la question, puis retrouver les morceaux dont les vecteurs sont les plus proches.
- Générer : envoyer au LLM la question et ces morceaux, avec la consigne de s’appuyer sur eux.
Les pipelines soignés ajoutent deux briques. La recherche hybride combine les embeddings, qui captent le sens, et une recherche par mots-clés comme BM25, qui attrape les termes exacts : un code d’erreur, une référence produit. Le reranking reclasse ensuite les candidats pour ne garder que les meilleurs. Anthropic a publié en septembre 2024 une méthode, la Contextual Retrieval, qui ajoute à chaque morceau un court résumé de son contexte : sur ses tests, elle réduit de 49 % les recherches ratées, et de 67 % avec un reranking.
Embeddings et base de données vectorielle
Un embedding est la représentation numérique d’un texte : un vecteur de quelques centaines ou milliers de nombres, construit de façon que deux textes de sens voisin donnent deux vecteurs proches. « Rembourser une commande » et « obtenir un avoir » peuvent ainsi se retrouver côte à côte, sans un mot en commun. La proximité se mesure en général par la similarité cosinus ou le produit scalaire.
Anthropic ne propose pas de modèle d’embedding et oriente vers Voyage AI, qui appartient à MongoDB. Son modèle généraliste voyage-4, par exemple, produit par défaut des vecteurs de 1 024 dimensions, normalisés : produit scalaire et similarité cosinus y donnent alors le même résultat.
Une base de données vectorielle range ces vecteurs et sait retrouver vite les plus proches d’un vecteur donné. MongoDB Vector Search, par exemple, propose une recherche exacte (ENN) et une recherche approximative (ANN), plus rapide sur de gros volumes. Plusieurs familles existent :
| Solution | Ce que c’est |
|---|---|
| MongoDB Vector Search |
Recherche vectorielle de MongoDB, sur Atlas ou installé chez vous, à
côté de vos autres données, par l’étape d’agrégation
$vectorSearch
|
| pgvector | Extension open source de PostgreSQL : distance euclidienne, produit scalaire et cosinus |
| Pinecone | Base vectorielle en service entièrement managé, utilisée dans la recette RAG de la documentation d’Anthropic |
Pour un projet qui a déjà une base de données, le plus simple est souvent de rester dessus : MongoDB, et PostgreSQL avec pgvector, savent stocker et chercher des vecteurs.
Un exemple simple
Pour voir le mécanisme sans clé d’API ni base de données, voici un mini-RAG en Python, sans aucune dépendance. Le « modèle d’embedding » y est remplacé par un simple comptage de mots : c’est grossier, mais le principe est le même.
import math
import re
from collections import Counter

documents = [
    "Le télétravail est possible deux jours par semaine, avec l'accord du responsable.",
    "Les notes de frais se déposent avant le 5 du mois suivant dans l'outil de gestion.",
    "La salle de réunion du troisième étage se réserve depuis l'agenda partagé.",
    "Les congés se posent au moins deux semaines à l'avance.",
]


def vectoriser(texte):
    """Tient le rôle du modèle d'embedding : compte les mots du texte."""
    return Counter(re.findall(r"\w+", texte.lower()))


def similarite(a, b):
    """Similarité cosinus entre deux vecteurs."""
    produit = sum(a[mot] * b[mot] for mot in a)
    normes = math.sqrt(sum(v * v for v in a.values())) * math.sqrt(
        sum(v * v for v in b.values())
    )
    return produit / normes if normes else 0.0


# 1. Indexer : un vecteur par document
index = [(doc, vectoriser(doc)) for doc in documents]

# 2. Rechercher : les deux documents les plus proches de la question
question = "Avant quelle date faut-il déposer les notes de frais ?"
v_question = vectoriser(question)
resultats = sorted(
    index, key=lambda paire: similarite(v_question, paire[1]), reverse=True
)
extraits = "\n".join(f"- {doc}" for doc, _ in resultats[:2])

# 3. Augmenter : le prompt qui partira vers le LLM
prompt = f"""Réponds à la question en t'appuyant uniquement sur ces extraits.
Si la réponse n'y est pas, dis que tu ne sais pas.

Extraits :
{extraits}

Question : {question}"""
print(prompt)
Le programme affiche le prompt augmenté :
Réponds à la question en t'appuyant uniquement sur ces extraits.
Si la réponse n'y est pas, dis que tu ne sais pas.

Extraits :
- Les notes de frais se déposent avant le 5 du mois suivant dans l'outil de gestion.
- Les congés se posent au moins deux semaines à l'avance.

Question : Avant quelle date faut-il déposer les notes de frais ?
Le bon document arrive en tête ; le second, sur les congés, n’a rien à voir : il ne partage avec la question que le mot « les ». C’est exactement ce que corrige un vrai modèle d’embedding, qui compare le sens et non les mots. Pour passer en production, il reste trois remplacements : vectoriser() par l’appel à un modèle d’embedding, la liste index par une base vectorielle, et le print par l’envoi du prompt à un LLM, par son API. La consigne « dis que tu ne sais pas » n’est pas décorative : la documentation d’Anthropic la cite comme le premier moyen de réduire les hallucinations.
RAG, fine-tuning ou long contexte ?
Le RAG n’est pas la seule façon de donner des connaissances à un modèle. Avec des fenêtres de contexte qui atteignent 1 million de jetons sur les modèles Claude actuels, on peut parfois tout mettre dans le prompt. Anthropic le suggère d’ailleurs sous 200 000 jetons de base de connaissances, soit environ 500 pages. Mais plus le contexte est long, plus la précision et le rappel se dégradent : la documentation parle de « context rot ».
| Approche | Quand la choisir | Sa limite |
|---|---|---|
| RAG | Beaucoup de documents, qui changent, et des réponses à sourcer | Tout dépend de la qualité de la recherche |
| Long contexte | Une base qui tient dans le prompt (moins de 200 000 jetons) | Coût de chaque requête, précision qui baisse avec la longueur |
| Fine-tuning | Adapter un style, un format ou une tâche précise | Ce qui est appris dans les paramètres se met mal à jour, comme le notait déjà l’article du RAG ; l’API Claude ne le propose pas |
| Les apprendre | La formation IA pour développeurs : LLM, API, RAG, agents et MCP | |
En pratique, ces approches se combinent : un RAG pour trouver les bons documents, le cache de prompt pour payer moins cher un long contexte fixe, et un agent qui décide lui-même quand chercher. Pour aller plus loin côté outils, voyez aussi la formation Claude Code. Et si vous voulez profiter du RAG sans coder, les projets Claude y passent d’eux-mêmes sur les offres payantes, quand vos fichiers approchent la limite du contexte : la formation Claude y consacre un chapitre.
Questions fréquentes
Que veut dire RAG ?
Le RAG supprime-t-il les hallucinations ?
Faut-il forcément une base vectorielle ?
Peut-on faire du RAG avec Claude ?
RAG ou agent : quelle différence ?